HuskyDoge
  • About
  • Research
  • Blogs
  • Misc
Xiaohongshu

#Diffusion

Research

Mask Tokens as Prophet: Fine-Grained Cache Eviction for Efficient dLLM Inference
Jianuo Huang, Yaojie Zhang, Yicun Yang, Benhao Huang, Biqing Qi, Dongrui Liu, Linfeng Zhang
Oct 10th 2025
#Diffusion
#LLM
#Efficiency

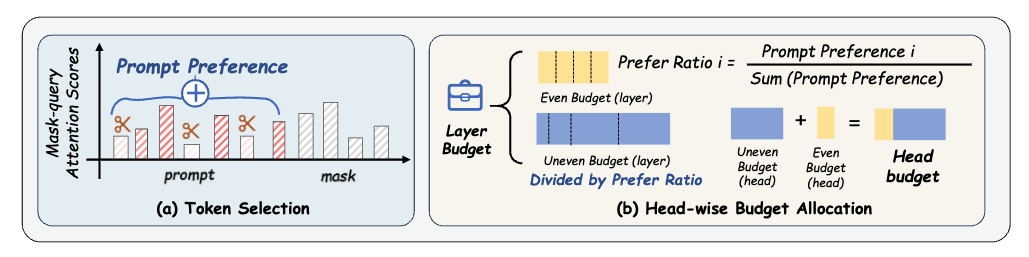
MaskKV exploits mask-token attention signals to evict low-utility KV pairs in diffusion LLMs, shrinking cache budgets while preserving long-context accuracy and increasing throughput.

paper
code
Mask Tokens as Prophet: Fine-Grained Cache Eviction for Efficient dLLM Inference
FreqCa: Accelerating Diffusion Models via Frequency-Aware Caching
Jiacheng Liu, Peiliang Cai, Qinming Zhou, Yuqi Lin, Deyang Kong, Benhao Huang, Yupei Pan, Haowen Xu, Chang Zou, Junshu Tang, Shikang Zheng, Linfeng Zhang
Oct 9th 2025
#Diffusion
#Efficiency

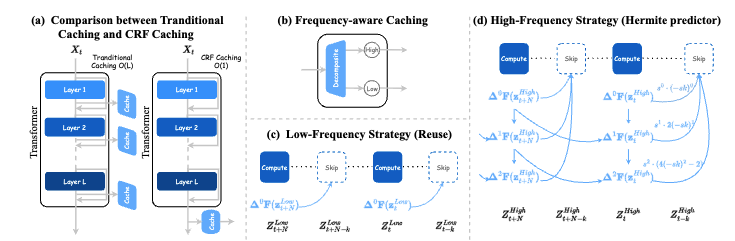
FreqCa accelerates diffusion models by analyzing frequency dynamics of features across timesteps, reusing low-frequency components and interpolating high-frequency ones with great memory reduction.
paper
FreqCa: Accelerating Diffusion Models via Frequency-Aware Caching